
Lección 522 min60 XPGratis
Qué hace un quant de verdad
Al terminar sabrás
- Describir el ciclo de trabajo de un quant en cinco pasos
- Escribir una hipótesis de estrategia antes de mirar los datos
- Comparar un resultado con lo que produciría el azar y decidir si merece seguir
Antes de esta conviene haber hecho Azar o habilidad: por qué una racha no demuestra nada.
La imagen del quant es alguien con seis pantallas y ecuaciones. La realidad se parece más a un científico aburrido: escribe qué espera encontrar, lo mide, lo compara con lo que saldría por casualidad, y la mayoría de las veces tira la idea a la basura. Esta lección te enseña ese ciclo completo con 30 líneas de código, y de paso vas a ver cómo unos datos sin nada dentro casi nos convencen de que había algo.
El problema
Sin un método, mirar datos es mirar nubes: siempre ves formas. El método del quant existe para protegerte de ti mismo. Y tiene un orden concreto que no se puede alterar, porque el orden es lo que evita el autoengaño.
Tres capas
Intuición
Un quant es un detective con una regla estricta: escribe el nombre del culpable antes de entrar en la casa. Si entra primero y luego decide, siempre "encontrará" pruebas contra alguien, porque en cualquier casa hay cosas raras. Escribir la hipótesis antes de mirar los datos es la única forma de que los datos puedan decirte que no.
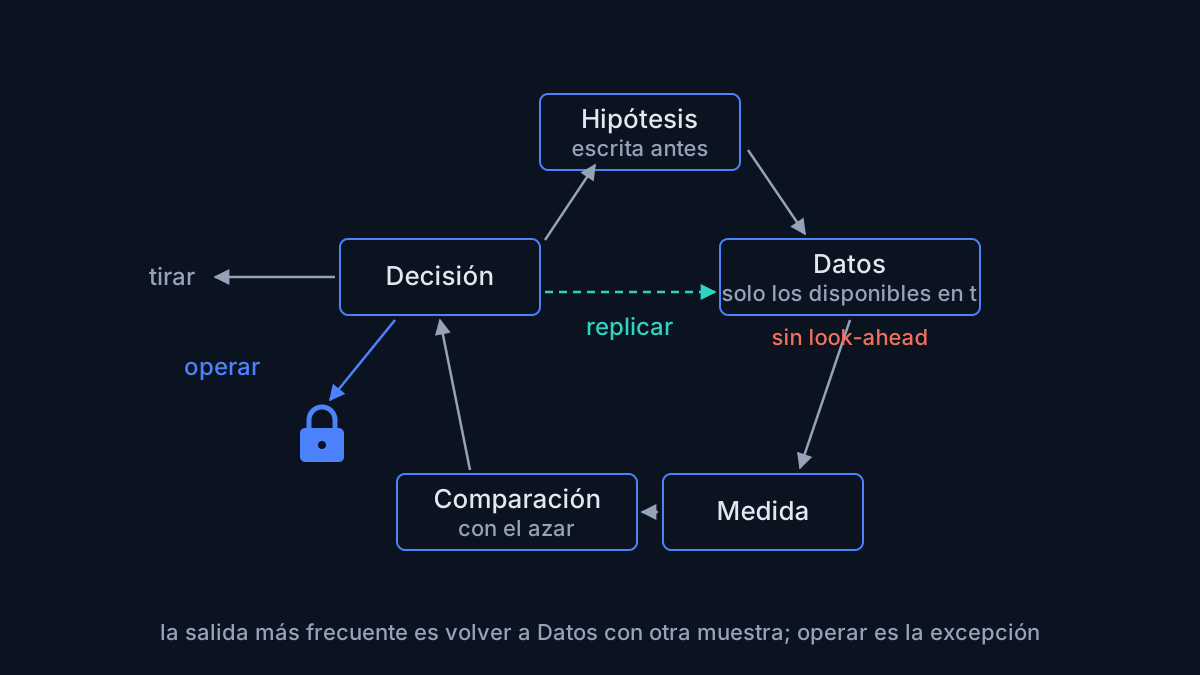
El ciclo tiene cinco pasos y siempre en este orden:
- Hipótesis. Una frase que dice qué esperas y por qué debería ser cierto.
- Datos. Los que existían en cada momento, ni uno más.
- Medida. Un número que sale de aplicar la hipótesis a los datos.
- Comparación con el azar. ¿Qué número saldría si no hubiera nada?
- Decisión. Tirar la idea, seguir investigando o, muy rara vez, operar.
Lo que no hace un quant: mirar un gráfico, ver un patrón, y buscar datos que lo confirmen. Eso es lo que hace todo el mundo, y por eso a todo el mundo le sale.
Ejemplo numérico
Hipótesis, escrita antes de tocar datos: "Tras un día de caída fuerte (más de un 2 %), el día siguiente tiende a rebotar, porque el pánico se pasa de frenada."
Datos: 1.260 días de retornos (cinco años). Para este ejemplo los generamos aleatorios a propósito: sabemos que no hay nada dentro.
Medida: hay 59 días que vienen después de una caída de más del 2 %. Su retorno medio es −0,46 %. La media de cualquier día es −0,001 %. Vaya: el día después de una caída no rebota, cae más. La hipótesis está al revés, pero hay algo.
Comparación con el azar: cogemos 59 días cualesquiera al azar, calculamos su media, y repetimos 1.000 veces. Nuestro −0,46 % es más extremo que todas esas 1.000 medias: percentil 0 %.
Decisión: "algo hay, seguir investigando". Y aquí es donde un quant hace lo que un aficionado no hace: repite con otros datos. Con siete semillas distintas, igual de aleatorias, la media tras caída es: −0,21 %, +0,01 %, +0,11 %, +0,17 %, −0,14 %, −0,17 %, −0,19 %. Alrededor de cero. El −0,46 % de la semilla 42 era una casualidad de tres desviaciones típicas, que aparece una vez cada 300 intentos. Los datos no tenían nada, y una sola prueba dijo que sí.
Formal
El ciclo, en términos técnicos:
-
Hipótesis : especifica el instrumento, la señal (una función solo de información disponible en ), la regla de posición y la métrica objetivo. Debe incluir un mecanismo económico o de comportamiento que explique por qué el edge existiría y por qué no lo habrían arbitrado ya.
-
Datos: la restricción crítica es que , la información disponible en . Usar , un cierre ajustado con información posterior o un dato macro publicado después es look-ahead bias. En el código,
r.shift(1)desplaza la señal un periodo: usamos el retorno de ayer para decidir hoy. Quitar eseshiftes el error más frecuente y más destructivo del research (Nivel 3, módulo 1). -
Medida: aquí, la media condicional frente a la incondicional . En una estrategia completa la métrica sería el Sharpe, el drawdown, el profit factor tras costes (Nivel 3, módulo 4).
-
Comparación con el azar: un test de permutación o de remuestreo. Bajo la hipótesis nula de que la señal no informa, la media de días seleccionados por la señal se distribuye igual que la media de días elegidos al azar. Se genera esa distribución empírica y se sitúa la medida observada. El error típico teórico es , así que está a . Bajo normalidad, : con 300 hipótesis probadas, esperas una así.
-
Decisión y replicación: un solo test significativo no basta, por el sesgo de selección de la lección anterior. La replicación fuera de muestra (otros periodos, otros activos, otras semillas si es simulación) es obligatoria antes de dar un paso más. El Nivel 3 formaliza esto con walk-forward, permutación, PBO y deflated Sharpe.
Todo el ciclo debe ser reproducible: mismo código, misma semilla, mismos datos, mismo resultado al decimal. Si no lo es, no es research, es una anécdota.
Ejemplo trabajado con código
# numpy 2.4 · pandas 3.0 — El ciclo mínimo de un quant: hipótesis -> medida -> comparación con el azar
import numpy as np, pandas as pd
rng = np.random.default_rng(42)

# Hipótesis (escrita ANTES de mirar datos): "tras un día de caída fuerte (< -2 %), el día siguiente
# tiende a rebotar". Datos: 5 años de retornos diarios SIMULADOS sin ninguna estructura (ventaja cero).
r = pd.Series(rng.normal(0.0003, 0.012, 252 * 5))
señal = r.shift(1) < -0.02            # la señal usa el retorno de AYER: sin look-ahead
r_tras_caida = r[señal]
print(f"Días con caída > 2 % el día anterior: {señal.sum()}")
print(f"Retorno medio del día siguiente:      {r_tras_caida.mean():+.4%}")
print(f"Retorno medio de cualquier día:       {r.mean():+.4%}")

# Comparar con el azar: ¿qué media saldría eligiendo el mismo nº de días AL AZAR? (1.000 veces)
medias_azar = np.array([r.sample(señal.sum(), random_state=int(s)).mean() for s in rng.integers(0, 1e9, 1000)])
percentil = (medias_azar < r_tras_caida.mean()).mean()
print(f"La media observada está en el percentil {percentil:.0%} de lo que produce el azar")
print("Veredicto:", "no se distingue del azar -> hipótesis NO confirmada" if 0.05 < percentil < 0.95 else "algo hay -> seguir investigando")

# Un quant no se para aquí. Repite el experimento con otros datos (otras semillas) antes de creérselo.
print("\nMismo test con otras 7 semillas (datos igual de aleatorios):")
for seed in range(1, 8):
    rr = pd.Series(np.random.default_rng(seed).normal(0.0003, 0.012, 252 * 5))
    ss = rr.shift(1) < -0.02
    print(f"  semilla {seed}: media tras caída {rr[ss].mean():+.4%}  (n={ss.sum()})")
print("Veredicto final: el resultado de la semilla 42 era una casualidad de 3 sigmas. Los datos no tenían nada.")
Días con caída > 2 % el día anterior: 59
Retorno medio del día siguiente: -0.4631%
Retorno medio de cualquier día: -0.0013%
La media observada está en el percentil 0% de lo que produce el azar
Veredicto: algo hay -> seguir investigando
Mismo test con otras 7 semillas (datos igual de aleatorios):
semilla 1: media tras caída -0.2056% (n=57)
semilla 2: media tras caída +0.0147% (n=65)
semilla 3: media tras caída +0.1078% (n=52)
semilla 4: media tras caída +0.1726% (n=58)
semilla 5: media tras caída -0.1359% (n=46)
semilla 6: media tras caída -0.1718% (n=55)
semilla 7: media tras caída -0.1865% (n=58)
Veredicto final: el resultado de la semilla 42 era una casualidad de 3 sigmas. Los datos no tenían nada.No elegimos la semilla 42 para que esto pasara; es la semilla que usa toda la academia. Salió así, y es la mejor demostración posible de por qué una sola prueba no vale.
Figura
(Figura estática en SVG; no requiere código.)
El error típico
Formular la hipótesis después de ver el resultado. Se mira el gráfico, se ve que "tras las caídas fuertes rebota", se programa, sale bien, y uno se convence de que lo predijo. En realidad la hipótesis se ajustó a los datos que ya conocías, y el test la confirma porque la sacaste de ahí. La defensa es mecánica: escribe la hipótesis en un archivo con fecha antes de ejecutar nada, y no la cambies aunque el resultado te tiente. Si quieres probar otra, es otra hipótesis, se anota, y cuenta como un intento más para la lección anterior.
Quiz
5 preguntas · se aprueba con 60 %
1.¿Cuál es el orden correcto del ciclo?
2.En el código, ¿qué pasaría si quitamos el `.shift(1)` de la señal?
3.La media observada está en el percentil 0 % de 1.000 medias aleatorias. ¿Qué concluyes?
4.¿Qué es una hipótesis de estrategia bien formulada?
5.Repites el test con siete semillas y las medias salen alrededor de cero. ¿Qué has aprendido?
0 de 5 respondidas
Ejercicio
Escribe en un archivo de texto, con fecha, una hipótesis propia sobre cualquier activo que sigas, con el formato de la opción b) del quiz: señal medible, regla, mecanismo y métrica. Después:
- Cambia el umbral del código de −2 % a −1,5 % y a −3 %. Anota cuántos días activan la señal y la media en cada caso, con la semilla 42.
- Explica en dos frases por qué probar tres umbrales sobre los mismos datos no son tres pruebas independientes.
Resultado verificable con semilla 42: con −1,5 % la señal se activa 131 días y la media tras caída es −0,34 %; con −3 % se activa solo 7 días y la media es −0,37 %, pero con 7 datos ese número no significa nada. Fíjate en que la semilla 42 sigue dando negativo con los tres umbrales: es la misma casualidad vista tres veces, no tres pruebas independientes. Cambia la semilla y desaparece.
Qué te llevas
- Hipótesis antes que datos, siempre. Es lo único que permite que los datos digan que no.
- Un resultado se compara con lo que produciría el azar, y si es raro se replica antes de creerlo. Una prueba no vale.
- La señal solo puede usar lo que existía en el momento. El
shift(1)no es estilo, es la diferencia entre research y ficción.
Fin del módulo M0.1. Toca el examen: 15 preguntas de un banco de 32, aprobado con el 80 %. Después: M0.2, El instrumento: futuro, CFD y spot, donde aprendes qué compras cuando compras "ES".